希姆云平台产品简介
在人工智能和大数据驱动的数字化转型浪潮中,各行各业都在尝试用AI重塑核心竞争力,无论是先进模型的训推还是AI应用的爆发都催生了海量的AI算力需求。企业迫切需要高效驾驭算力,提升资源管理、任务编排和应用交付的速度和质量。希姆计算始终秉持“算力即服务”的理念,针对私有云和混合算力场景下构建安全、灵活、高效计算平台的需求,推出了AI算力管理与调度平台——希姆云平台。
希姆云平台采用容器云路线,立足于Kubernetes生态,支持集中管理和智能调度大规模CPU、GPU、NPU及其他专用加速器,在AI时代为AI模型、算法、应用服务提供强大且灵活的算力支撑。相比传统云平台,希姆云平台更以应用为中心,聚焦于应用的敏捷交付、快速弹性、平滑迁移、主动运维等方面,更适合承载微服务架构、CI/CD、多租户、多云环境等需求。同时提供完善的大模型推理及微调能力,能够为多类型、多场景的大模型应用提供高性能、高灵活性的产品服务发布能力。
希姆云平台是面向未来的大规模智算算力管理方案,致力于突破算力孤岛和资源受限的桎梏,建设集中管理、智能编排、弹性伸缩、主动运维、可审计的算力及应用生态。无论是跨部门、多租户场景,还是跨硬件、多架构场景,都能够提供标准化、可扩展、可监控和可治理的能力,赋能企业以更低的成本、更高的效率、更安全可控的方式构建和运转人工智能和大数据业务。
产品架构
希姆云平台采用云管平台、算力调度平台和大模型平台分层的设计,云管平台统一纳管集群资源,算力调度平台面向组织提供资源管理机制,大模型平台则提供一站式大模型服务。
云管平台和算力调度平台的功能示意图如下:
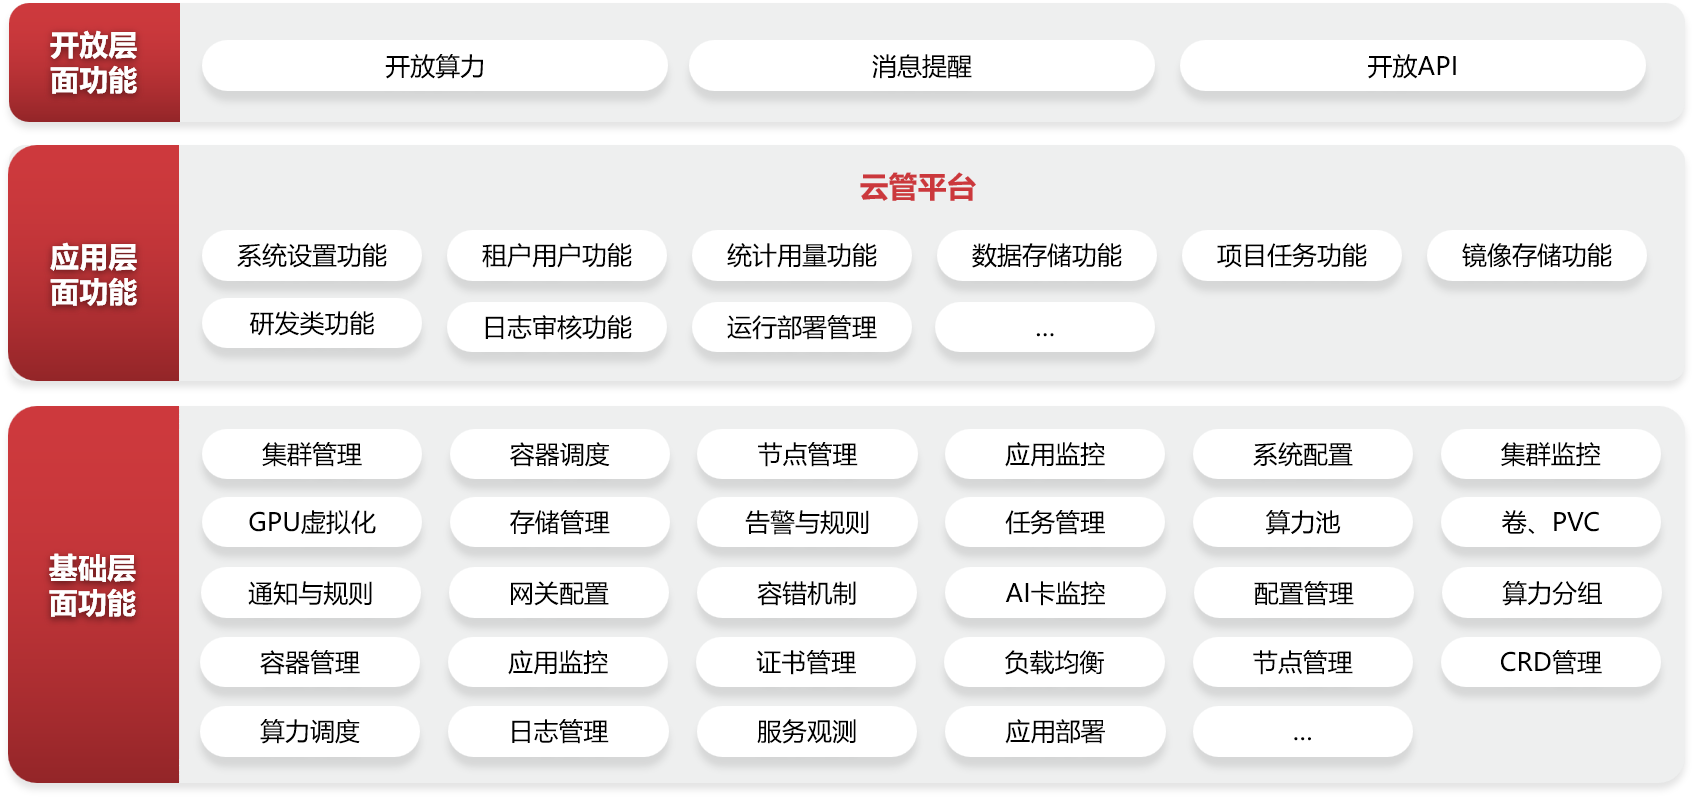
云管平台从服务器软硬件、应用集群等基础设施开始,基于Kubernetes实现算力池化、算力调度等平台功能,广泛适配AI加速卡,一站式纳管集群,并提供进阶的算力池管理、租户配额设置等算力资源的规划能力。同时基于Prometheus开发了与硬件适配的运维与监控体系,对AI加速卡以及云平台各项运行环境、资源、服务等进行实时监控,配合告警策略可以高效地完成运维工作,提升云平台的可靠性。
算力调度平台融合了多租户数据/功能隔离、多任务执行服务等特性,为每个企业和部门分配稳定、安全、便捷的算力资源;并通过项目汇总、研发管理、用户自服务、AI应用一站式支持等能力,应对场景迭代迅速、行业需求多样等问题,支持客户更顺畅地研发和发布自己的AI产品和服务。
大模型平台的功能示意图如下:
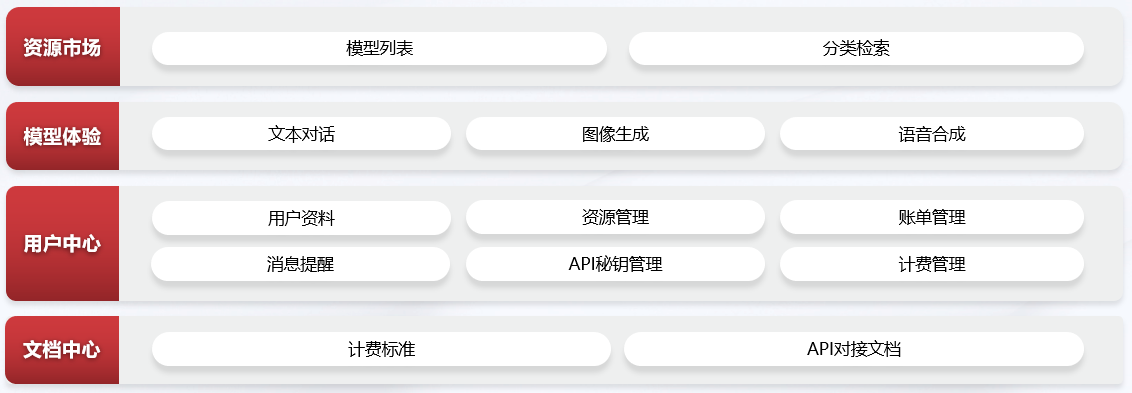
大模型平台覆盖从资源获取到深度使用的全流程,实现了资源可发现、体验可交互、账户可管理、接入可支撑的全链路服务闭环。
产品特点
- 面向硬件的广泛适配:集中管理和共享调度基于x86、ARM、GPU、NPU等不同硬件架构的算力,突破算力孤岛限制,实现异构算力一体化管理;并提供GPU/NPU管理插件、算力亲和性控制、驱动管理和硬件拓扑感知等能力,适配企业面临的各种专用计算场景。
- 面向运营的主动运维:集中管理私有云中的多个集群的计算、存储、网络等资源,通过自动化部署、自动化排障等机制简化应用部署并保持应用健康运行;并配套适配多样化硬件的监控体系,通过实时监控、告警策略、审计日志等机制实现高效的可视化运维和主动运维,确保平台管理透明、合规可控、稳定可靠。
- 面向组织的安全隔离:融合租户/项目/应用级别隔离设计、精细化访问控制、精细化配额管理、智能资源调度等机制,既能保障数据安全,也实现了多层级灵活分配资源,服务于众多业务和团队时也能达到高效负载均衡和极致算力利用。
- 面向应用的完整闭环:容器云的技术路线天然适合打造敏捷交付、快速弹性的研发体验,尤其在大模型应用方面,提供模型微调、模型库管理、推理引擎加速、服务编排发布等全栈能力,实现了全生命周期支持。
使用须知
使用希姆云平台过程中涉及的主要角色和功能模块关系如下:

- 云管平台的系统管理员负责管理云管平台的组织架构、集群资源、租户信息等,对租户内部的应用环境、项目、应用、镜像等研发资源仅有查看权限,无管理权限。
- 算力调度平台的租户管理员负责管理租户的组织架构以及应用环境、项目、应用、企业镜像等租户研发资源。
- 算力调度平台的租户用户基于自身权限管理参与的项目、应用、镜像等研发资源。
- 大模型平台的管理员负责管理模型用户、用户积分以及平台鉴权、模型部署、模型观测、调用统计等模型服务。
- 大模型平台的模型用户通过体验中心或者API一站式获取模型服务,将AI能力无缝融入业务。
基本概念
建议了解以下基本概念,有助于理解希姆云平台的功能逻辑。
- 平台范畴:
- 云管平台:统一纳管集群资源的平台。作为算力调度平台的后台,统一管理和分配通用算力、AI算力、分布式存储等资源,基于算力池和租户分配资源,并提供配套的监控告警、镜仓镜像、平台审计等功能。
- 算力调度平台:面向组织提供资源管理机制的平台。每个租户按需获取资源,租户之间资源强隔离保证安全性,租户内通过项目管理、成员管理、角色管理等手段实现高效精细地使用资源,满足在私有环境中开发应用的需求。
- 大模型平台:提供一站式大模型服务的平台。依托算力调度平台的资源,一站式完成部署模型、透出模型服务、观测模型状态、统计调用情况等操作,大大降低体验和集成模型能力的门槛。
- 用户:希姆云平台的用户以及身份标识,用户会根据职责被分配相应的角色,从而获得权限完成平台管理、租户管理、项目管理等工作。
- 角色:为用户设计的访问控制机制,基于角色可以高效管理用户对系统、资源等的访问权限。
- 资源范畴:
- 集群:一组相互独立的服务器经由高速通信网络所组成大型的算力系统。通过合理的集群配置、统一协调的管理可以满足企业对于算力、存储等类型资源的高性能、高可用性、高伸缩性等要求。
- 节点:集群中的一台物理服务器或者虚拟机都可以配置为一个集群节点。节点分为控制节点和工作节点,控制节点用于管理集群资源以及集群配置,工作节点用于启动容器组并执行各类工作负载。
- 算力池:集群资源的精细化管理机制,将集群资源划分为面向特定租户的专属算力池。
- 命名空间:云管平台中,系统管理员为完成平台运维任务创建的环境,用于运行系统管理程序。
- 应用环境:算力调度平台中,租户管理员为完成应用开发部署任务创建的环境,用于开发和部署业务应用。
- 应用范畴:
- 项目:租户中组织研发工作的机制,应用必须属于一个项目,例如同一个业务相关的应用汇总到一个项目中进行管理。
- 应用:用于提供某种服务的程序,例如提供网页浏览功能的Web应用。
- 容器组:应用的基本执行单元,一个应用可以包含一个或多个容器组,用于处理业务请求,例如运行Web应用前端、后端、数据库等模块的容器组。
- 服务:服务用于关联一组提供相同功能的容器组,将容器组的Endpoint组成单一资源,从而将运行在容器组上的应用程序转为公开的网络服务。服务提供了一个稳定的访问入口,在应用负载动态伸缩或升级时也不需要修改客户端的访问地址。例如创建一个服务来暴露一个Web应用,客户端可以通过服务的域名绑定形式或NodeIP:NodePort来访问Web应用。
- 镜像:一种打包应用程序的方式,方便快速部署和发布应用。希姆云平台支持多种镜像类型,包括个人用户的私有镜像、租户管理员添加和维护的共享镜像、系统管理员添加和维护的公共镜像。